Głęboka segmentacja wodnych dróg śródlądowych
Problem segmentacji dróg wodnych dotyczy automatycznego rozróżnienia lustra wody od brzegu oraz innych obiektów.
Proponowane podejście
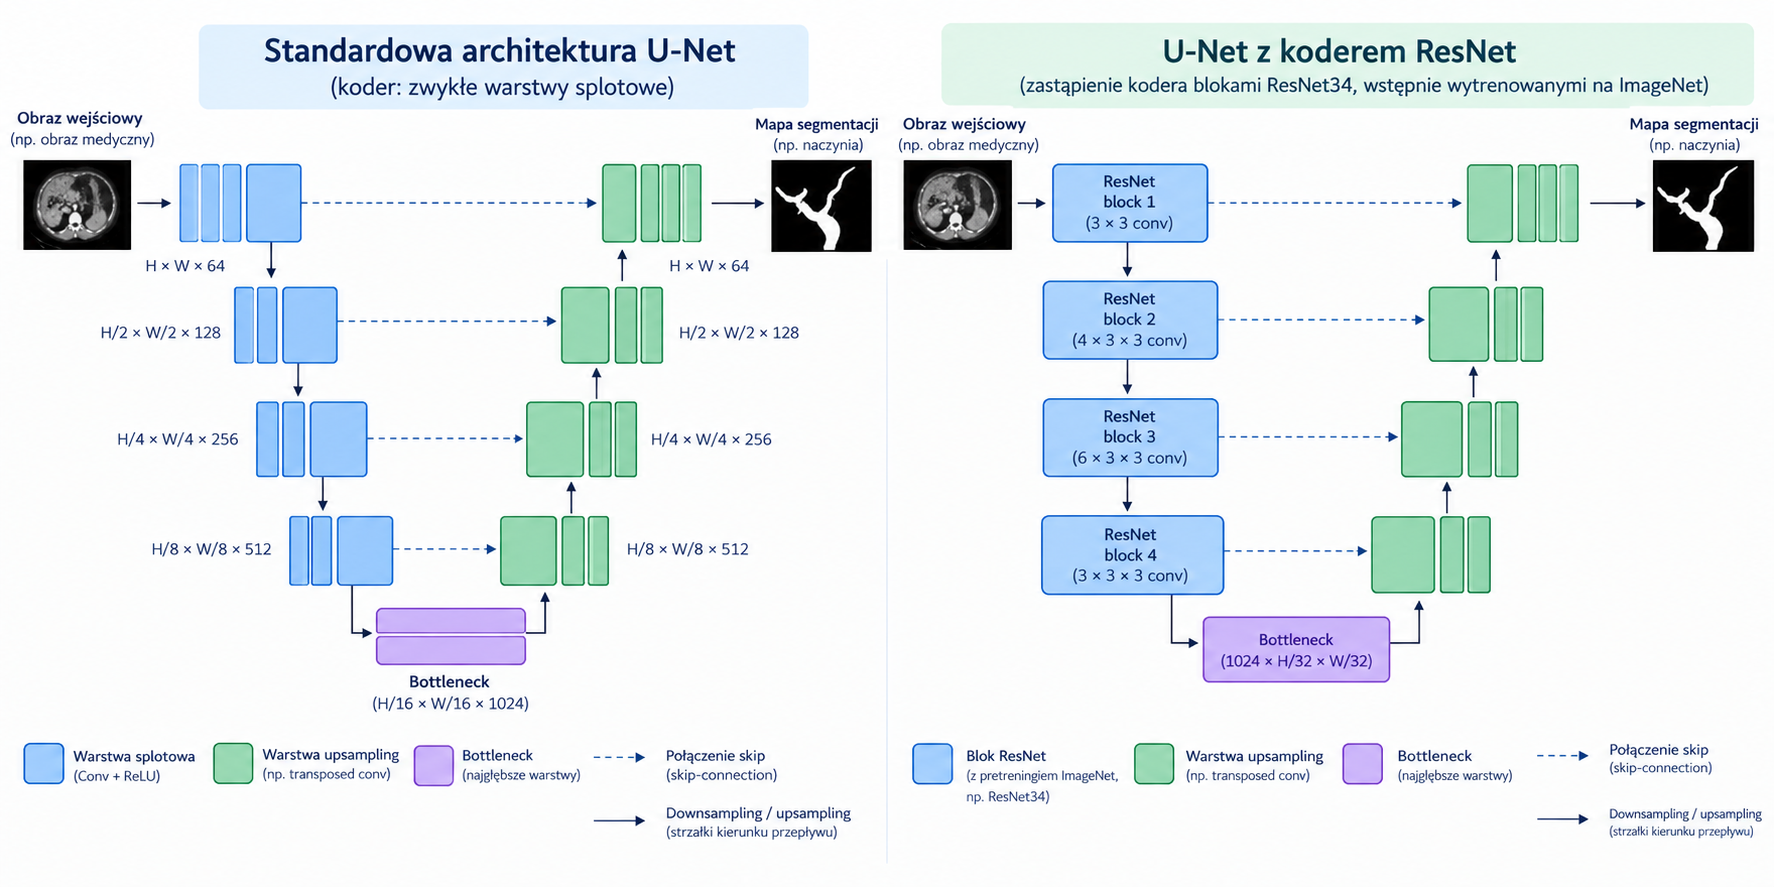
Zastosowanie architektury U-Net, ze wstępnie wytrenowanym koderem ResNet34.
U-Net to architektura typu koder-dekoder stworzona w 2015 roku, w celu segmentacji obrazów biomedycznych. Istotą tej architektury są połączenia (skip-connections) pomiędzy odpowiednimi warstwami kodera i dekodera.
Architektura U-Net znajduje szerokie zastosowanie w zagadnieniach segmentacji, stosowano ją na przykład do detekcji dróg w obrazach lotnicznych, przetwarzania obrazów satelitarnych czy segmentacji otoczenia w pojazdach autonomicznych.
W proponowanym modelu U-Net, koder składający się ze zwkyłych warstw splotowych, jest zastąpiony przez bloki sieci ResNet. W sumie koder będzie miał 33 warstwy (z sieci ResNet34 odrzucono ostatnią, w pełni połączoną warstwę). Koder zostanie zainicjalizowany wagami wstępnie wytrenowanymi na zbiorze ImageNet (wykorzystane wagi pochodzą z repozytrium udostępnionego przez PyTorch).
Proponowany model na wejściu przyjmuje kolorowy obraz z kanałami RGB. Aby zapewnić, że wstępnie wytrenowany koder działa poprawnie, zastosowany zostanie preprocessing zgodny ze standardem ImageNet. Obejmuje on skalowanie wartości pikseli do zakresu [0, 1] oraz normalizację przy użyciu średniej i odchylenia standardowego dla zbioru ImageNet.
Wyjście modelu ma taki sam rozmiar jak obraz wejściowy, ale z jednym kanałem. Na wyjściu modelu zaaplikowana zostanie funkcja aktywacji sigmoid wartości wyjściowe mogą być interpetowane jako prawdopodbieństwo przynależności danego piksela, do klasy, w tym przypadku wody. Funkcja straty modelu oparta jest o współczynnik Sorensena i nosi nazwę Dice Loss
$$\mathcal{L}_{\text{Dice}} = 1 - \frac{2 \sum_i y_i \hat{y}_i + \epsilon}{\sum_i y_i + \sum_i \hat{y}_i + \epsilon}$$
Strategia uczenia tak zmodyfikowanego modelu u-net moze przebiegać następująco:
- W pierwszym etapie wagi enkodera są zamrożone (frozen), uczone są jedynie wagi dekodera.
- W następnym etapie kolejne warstwy wag enkodera (zaczynając od góry) mogą być odblokowane i wytrenowane od nowa na zbiorze treningowym, w celu lepszej adaptacji do zadania.
Zbiór danych
Proponowane rozwiązanie zostanie przetestowane na zbiorze danych LaRS (Lakes, Rivers, Seas). Jest to zbiór przeznaczony do panoptycznej segmentacji oraz detekcji obiektów w środowiskach wodnych. Zawiera sceny rejestrowane na jeziorach, rzekach i morzach, dzięki czemu dobrze odzwierciedla zmienne warunki, takie jak różne typy zbiorników, oświetlenie czy pogoda.
Implementacja
Model został zaimplementowany z wykorzystaniem języka Python oraz biblioteki Segmentation Models PyTroch (SMP), która stanowi nakładke na PyTorch, dodającą modele segmentacji. Biblioteka ta jest często wykorzystywana w badaniach czy konkursach dotyczących uczenia maszynowego.
Kod zawiera klase generująca obiekt Dataset
class WaterBinaryDataset(Dataset):
    def __init__(self, root, split, image_size, augmentations=None):
        self.split = split
        self.image_size = image_size
        self.augmentations = augmentations

        self.image_dir = Path(root) / split / "images"
        self.mask_dir = Path(root) / split / "semantic_masks"

        self.image_paths = sorted(self.image_dir.glob("*.jpg"))

        self.has_masks = self.mask_dir.exists() and len(list(self.mask_dir.glob("*.png"))) > 0

        if self.has_masks:
            self.mask_paths = {p.stem: p for p in self.mask_dir.glob("*.png")}
            self.pairs = [
                (img, self.mask_paths[img.stem])
                for img in self.image_paths
                if img.stem in self.mask_paths
            ]
        else:
            # Test images
            self.pairs = self.image_paths

        self.resize = T.Resize(
            size=(image_size, image_size),
            interpolation=InterpolationMode.BILINEAR,
            antialias=True,
        )

        print(f"{split}: {len(self.pairs)} samples | masks: {self.has_masks}")

    def __len__(self):
        return len(self.pairs)

    def __getitem__(self, idx):

        # Test Images
        if not self.has_masks:
            img_path = self.pairs[idx]
            image = read_image(str(img_path)).float() / 255.0
            image = tv_tensors.Image(image)

            image = self.resize(image)

            if self.augmentations is not None:
                image = self.augmentations(image)

            return image.as_subclass(torch.Tensor)

        # Train and val images
        img_path, mask_path = self.pairs[idx]

        image = read_image(str(img_path)).float() / 255.0
        mask = read_image(str(mask_path))[0].long()

        mask[mask == 255] = 0
        mask = (mask == 1).float()
        mask = mask.unsqueeze(0)

        image = tv_tensors.Image(image)
        mask = tv_tensors.Mask(mask)

        image, mask = self.resize(image, mask)

        if self.augmentations is not None:
            image, mask = self.augmentations(image, mask)

        return image.as_subclass(torch.Tensor), mask.as_subclass(torch.Tensor)
Definicje modelu w PyTroch, korzystającego dodatkowo z bibilioteki PyLighting
class WaterSegmentationModel(pl.LightningModule):
    def __init__(
        self,
        arch,
        encoder_name,
        in_channels,
        out_classes,
        t_max,
        lr=2e-4,
        trainable_backbone_layers=0,
        **kwargs
    ):
        super().__init__()
        self.save_hyperparameters()

        self.model = smp.create_model(
            arch,
            encoder_name=encoder_name,
            in_channels=in_channels,
            classes=out_classes,
            **kwargs,
        )

        params = smp.encoders.get_preprocessing_params(encoder_name)
        self.register_buffer("std", torch.tensor(params["std"]).view(1, 3, 1, 1))
        self.register_buffer("mean", torch.tensor(params["mean"]).view(1, 3, 1, 1))

        self.t_max = t_max
        self.loss_fn = smp.losses.DiceLoss(smp.losses.BINARY_MODE, from_logits=True)
        self.lr = lr

        self.trainable_backbone_layers = trainable_backbone_layers


        for param in self.model.encoder.parameters():
            param.requires_grad = False

        if trainable_backbone_layers > 0:
            for layer in list(self.model.encoder.children())[-self.trainable_backbone_layers:]:
                for param in layer.parameters():
                    param.requires_grad = True

        self.training_step_outputs = []
        self.validation_step_outputs = []
        self.test_step_outputs = []

    def forward(self, image):
        image = (image - self.mean) / self.std
        return self.model(image)

    def shared_step(self, batch, stage):
        image = batch[0]
        mask = batch[1]

        logits_mask = self.forward(image)
        loss = self.loss_fn(logits_mask, mask)

        prob_mask = logits_mask.sigmoid()
        pred_mask = (prob_mask > 0.5).float()

        tp, fp, fn, tn = smp.metrics.get_stats(
            pred_mask.long(), mask.long(), mode="binary"
        )

        self.log(f"{stage}_loss", loss, on_step=(stage == "train"), on_epoch=True, prog_bar=True)

        return {
            "loss": loss,
            "tp": tp,
            "fp": fp,
            "fn": fn,
            "tn": tn,
        }

    def shared_epoch_end(self, outputs, stage):
        tp = torch.cat([x["tp"] for x in outputs])
        fp = torch.cat([x["fp"] for x in outputs])
        fn = torch.cat([x["fn"] for x in outputs])
        tn = torch.cat([x["tn"] for x in outputs])

        # IoU (you already had this)
        per_image_iou = smp.metrics.iou_score(
            tp, fp, fn, tn, reduction="micro-imagewise"
        )
        dataset_iou = smp.metrics.iou_score(
            tp, fp, fn, tn, reduction="micro"
        )

        # Precision, recall, F1 (global / micro)
        tp_sum = tp.sum().float()
        fp_sum = fp.sum().float()
        fn_sum = fn.sum().float()
        eps = 1e-7

        precision = tp_sum / (tp_sum + fp_sum + eps)
        recall = tp_sum / (tp_sum + fn_sum + eps)
        f1 = 2 * precision * recall / (precision + recall + eps)

        self.log_dict(
            {
                f"{stage}_per_image_iou": per_image_iou,
                f"{stage}_dataset_iou": dataset_iou,
                f"{stage}_precision": precision,
                f"{stage}_recall": recall,
                f"{stage}_f1": f1,
            },
            prog_bar=True,
        )

    def training_step(self, batch, batch_idx):
        out = self.shared_step(batch, "train")
        self.training_step_outputs.append(out)
        return out["loss"]

    def on_train_epoch_end(self):
        self.shared_epoch_end(self.training_step_outputs, "train")
        self.training_step_outputs.clear()

    def validation_step(self, batch, batch_idx):
        out = self.shared_step(batch, "valid")
        self.validation_step_outputs.append(out)
        return out

    def on_validation_epoch_end(self):
        self.shared_epoch_end(self.validation_step_outputs, "valid")
        self.validation_step_outputs.clear()

    def test_step(self, batch, batch_idx):
        out = self.shared_step(batch, "test")
        self.test_step_outputs.append(out)
        return out

    def on_test_epoch_end(self):
        self.shared_epoch_end(self.test_step_outputs, "test")
        self.test_step_outputs.clear()

    def configure_optimizers(self):
        optimizer = torch.optim.Adam(self.parameters(), lr=self.lr)
        scheduler = lr_scheduler.CosineAnnealingLR(
            optimizer,
            T_max=self.t_max,
            eta_min=1e-5
        )
        return {
            "optimizer": optimizer,
            "lr_scheduler": {
                "scheduler": scheduler,
                "interval": "step",
                "frequency": 1,
            },
        }
Comments
Join the discussionNo comments yet. Be the first to comment.